InferSSD: el teu SSD és la nova VRAM
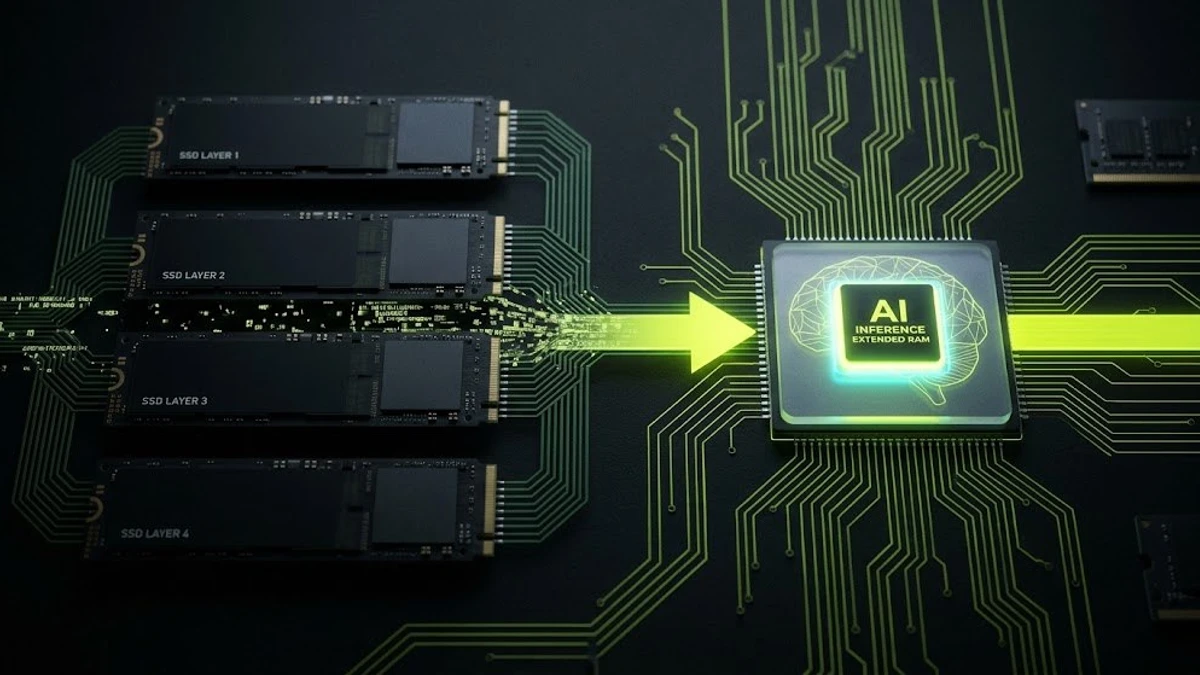
Hi ha un problema simple en IA local que ningú havia resolt bé: els models grans no caben a la teva memòria. Un model com DeepSeek-V4.1 té 763 mil milions de paràmetres. Ocupa centenars de gigabytes. El teu laptop té 32. La teva GPU té 16. El compte no quadra.
La resposta tradicional: compra més RAM. O paga una subscripció cloud. O conforma't amb models petits.
InferSSD proposa una altra resposta: usa el teu SSD.
La idea: SSD com a memòria estesa
InferSSD és un motor d'inferència open-source (llicència Apache 2.0) creat per WiCi AI, construït sobre llama.cpp. La seva premisa és simple d'entendre encara que la implementació sigui complexa:
En lloc de carregar tot el model a RAM o VRAM, guarda els pesos al SSD i carrega només el que cal, quan cal.
Però hi ha un truc. No funciona amb qualsevol model — funciona específicament amb models Mixture-of-Experts (MoE). I la raó és elegant.
Per què MoE ho fa possible
Un model MoE no usa tots els seus paràmetres en cada token. Per cada paraula que genera, el model selecciona un petit subconjunt d'"experts" — pensa-ho com un equip d'especialistes on només es consulten els rellevants per a cada tasca.
DeepSeek-V4.1 té 763B paràmetres totals, però només n'activa una fracció per cada token. InferSSD explota exactament això:
- El que canvia (atenció, KV cache, capes compartides) es queda a RAM/VRAM — és ràpid i es necessita constantment
- El que no canvia (els pesos dels experts) es queda al SSD — són centenars de gigabytes però només cal una fracció en cada moment
- Una cache intel·ligent manté a RAM els experts que s'usen freqüentment, evitant rellegir del SSD
El SSD no reemplaça la RAM. La complementa. És memòria estesa per a models que no caben, on només cal carregar la part activa.
Els números: 800B en una RTX 5090
Això no és teoria. InferSSD ja funciona. Els benchmarks són sorprenents:
- RTX 5090 (32GB RAM + 32GB VRAM): DeepSeek-V4.1 a 7.27 tokens/s en decode, 164.5 tokens/s en prefill. Això és utilitzable. Un model de 763B en una targeta gràfica de consum.
- MacBook Pro M5 Max (48GB unificada): 2.7 tokens/s decode. Lent però funcional — un model de 763B en un laptop.
- RTX 5060 Ti (8GB RAM + 16GB VRAM): 2.55 tokens/s. Sí, 8GB de RAM. El SSD fa la feina pesada.
Per posar-ho en perspectiva: llama.cpp sense InferSSD a la mateixa RTX 5090 fa 0.87 tokens/s. InferSSD és 8.4 vegades més ràpid en decode i 20 vegades més ràpid en prefill.
No és l'únic en aquesta direcció
La idea d'usar SSD com a memòria per a IA guja tracció:
- SSD-LLaMA (paper de setembre 2026): recerca acadèmica sobre inferència SSD-native per a models MoE de un bilió de paràmetres
- llama.cpp Expert-Aware SSD Streaming: discussió activa a la comunitat per integrar streaming d'experts des de SSD directament a llama.cpp
- SGLang SSD Expert Pack: treball conjunt entre WiCi i SGLang per optimitzar l'accés als experts des d'emmagatzematge
- Gandalf: estudi sobre l'impacte d'usar SSD per a KV caching i la durabilitat dels discs
La convergència és clara: la indústria està descobrint que el SSD no és només emmagatzematge — és una capa de memòria més.
I la durabilitat del SSD?
És la pregunta que tothom fa. No córrer un model d'IA des de SSD matarà el disc?
La resposta curta: no tant com podries pensar.
InferSSD llegeix pesos estàtics. No escriu. Els pesos del model no canvien durant la inferència — es llegeixen i es guarden a la cache a RAM. El desgast del SSD ve principalment de: descarregar els pesos (una sola vegada a la instal·lació), logs del sistema, swap de l'OS, i el manteniment intern del disc mateix.
WiCi va publicar un model de desgast que suggereix que, fins i tot en ús intensiu (4 hores contínues al dia), un SSD de qualitat pot durar anys abans d'esgotar el seu pressupost d'escriptura. Òbviament, això depèn del disc, la temperatura i la càrrega real. Però la idea que InferSSD "crema SSDs" és un mite.
Per què això canvia les regles
Si pots córrer un model de 800B en una RTX 5090, la pregunta "necessito el cloud?" esdevé molt més matisada.
No aniràs a substituir GPT-5 a casa. Però per a moltes aplicacions —inferència offline, fine-tuning local, privacitat de dades, experimentació— tenir accés a models de frontera en hardware de consum és un canvi de paradigma.
- Per a investigadors: pots experimentar amb models state-of-the-art sense pagar API
- Per a pimes: privacitat total, sense enviar dades a tercers, amb models que abans requerien data centers
- Per a desenvolupadors: un servidor amb una GPU decent i un SSD ràpid pot servir models de 800B a múltiples usuaris en paral·lel
El coll d'ampolla sempre va ser la memòria. InferSSD el mou al SSD, i els SSD NVMe moderns són sorprenentment ràpids. "No cab al meu ordinador" ja no és una resposta definitiva.
Conclusió
InferSSD no és màgia. Els models grans segueixen sent lents en hardware modest. 2.7 tokens/s en un MacBook no reemplaçarà una API cloud per a ús intensiu.
Però demostra quelcom important: el monopoli del cloud sobre els models grans s'està erosionant. Amb SSDs NVMe a preus assequibles, GPUs de consum cada cop més potents, i enginyeria com la d'InferSSD, la barrera per córrer models de frontera localment baixa cada mes.
Sam Altman diu que el teu PC és un malbaratament. InferSSD diu que el teu SSD és VRAM esperant ser usada. Ens quedem amb la segona opció.
També et pot interessar
Preparat per al salt tecnològic?
No deixis que la teva pime quedi obsoleta. Implementem la infraestructura d'IA que et donarà l'avantatge competitiva.
Reserva la teva Auditoria Gratuïta
