InferSSD : ton SSD est la nouvelle VRAM
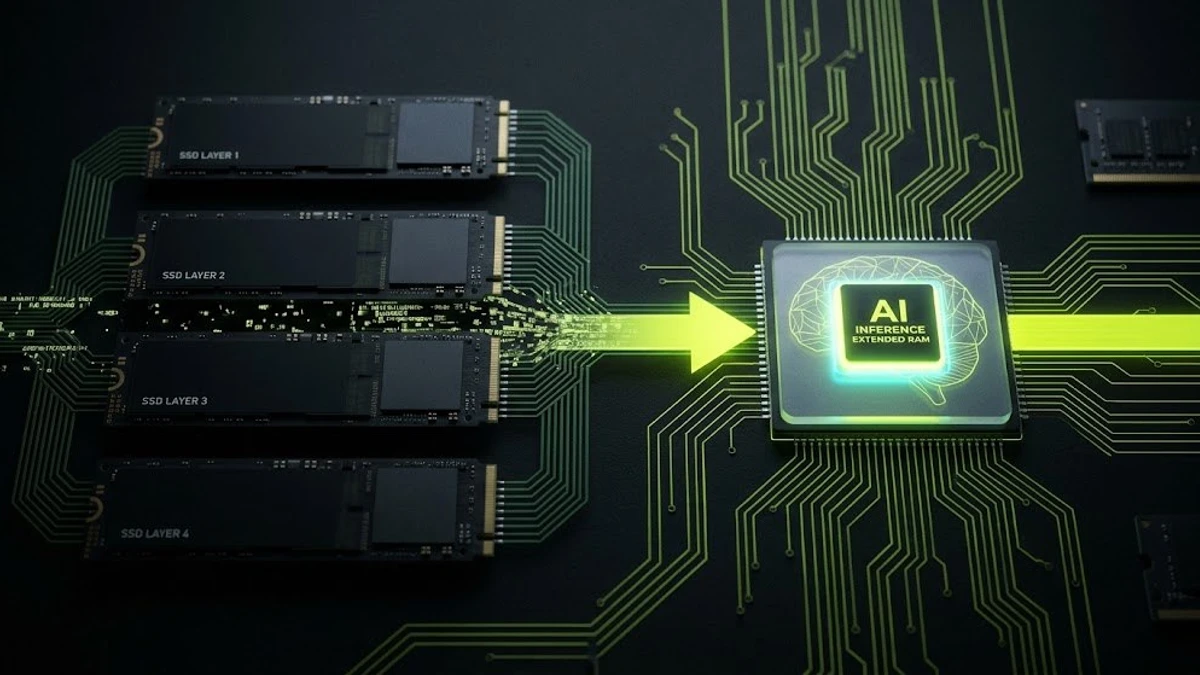
Il y a un problème simple en IA locale que personne n'avait bien résolu : les gros modèles ne tiennent pas dans ta mémoire. Un modèle comme DeepSeek-V4.1 a 763 milliards de paramètres. Il occupe des centaines de gigaoctets. Ton laptop a 32. Ton GPU a 16. Le compte ne tombe pas juste.
La réponse traditionnelle : achète plus de RAM. Ou paie un abonnement cloud. Ou contente-toi de petits modèles.
InferSSD propose une autre réponse : utilise ton SSD.
L'idée : le SSD comme mémoire étendue
InferSSD est un moteur d'inférence open-source (licence Apache 2.0) créé par WiCi AI, construit sur llama.cpp. Sa prémisse est simple à comprendre même si l'implémentation est complexe :
Au lieu de charger tout le modèle en RAM ou VRAM, il stocke les poids sur le SSD et ne charge que ce qui est nécessaire, quand c'est nécessaire.
Mais il y a un piège. Ça ne marche pas avec n'importe quel modèle — ça marche spécifiquement avec les modèles Mixture-of-Experts (MoE). Et la raison est élégante.
Pourquoi le MoE le rend possible
Un modèle MoE n'utilise pas tous ses paramètres sur chaque token. Pour chaque mot qu'il génère, le modèle sélectionne un petit sous-ensemble d'« experts » — pense-y comme une équipe de spécialistes où seuls les pertinents sont consultés pour chaque tâche.
DeepSeek-V4.1 a 763B paramètres totaux, mais n'en active qu'une fraction pour chaque token. InferSSD exploite exactement ça :
- Ce qui change (attention, KV cache, couches partagées) reste en RAM/VRAM — c'est rapide et nécessaire constamment
- Ce qui ne change pas (les poids des experts) reste sur SSD — c'est des centaines de gigaoctets mais seule une fraction est nécessaire à chaque instant
- Un cache intelligent garde en RAM les experts fréquemment utilisés, évitant de relire du SSD
Le SSD ne remplace pas la RAM. Il la complète. C'est de la mémoire étendue pour des modèles qui ne tiennent pas, où tu n'as besoin de charger que la partie active.
Les chiffres : 800B sur une RTX 5090
Ce n'est pas de la théorie. InferSSD fonctionne déjà. Les benchmarks sont surprenants :
- RTX 5090 (32 Go RAM + 32 Go VRAM) : DeepSeek-V4.1 à 7.27 tokens/s en decode, 164.5 tokens/s en prefill. C'est utilisable. Un modèle de 763B sur une carte graphique grand public.
- MacBook Pro M5 Max (48 Go unifiée) : 2.7 tokens/s decode. Lent mais fonctionnel — un modèle de 763B sur un laptop.
- RTX 5060 Ti (8 Go RAM + 16 Go VRAM) : 2.55 tokens/s. Oui, 8 Go de RAM. Le SSD fait le gros du travail.
Pour mettre en perspective : llama.cpp sans InferSSD sur la même RTX 5090 fait 0.87 tokens/s. InferSSD est 8.4 fois plus rapide en decode et 20 fois plus rapide en prefill.
Ce n'est pas le seul dans cette direction
L'idée d'utiliser le SSD comme mémoire pour l'IA gagne du terrain :
- SSD-LLaMA (paper de septembre 2026) : recherche académique sur l'inférence SSD-native pour des modèles MoE de mille milliards de paramètres
- llama.cpp Expert-Aware SSD Streaming : discussion active dans la communauté pour intégrer le streaming d'experts depuis le SSD directement dans llama.cpp
- SGLang SSD Expert Pack : travail conjoint entre WiCi et SGLang pour optimiser l'accès aux experts depuis le stockage
- Gandalf : étude sur l'impact d'utiliser le SSD pour le KV caching et la durabilité des disques
La convergence est claire : l'industrie découvre que le SSD n'est pas juste du stockage — c'est une couche de mémoire de plus.
Et la durabilité du SSD ?
C'est la question que tout le monde pose. Faire tourner un modèle d'IA depuis le SSD, ça ne va pas le tuer ?
La réponse courte : pas autant que tu pourrais penser.
InferSSD lit des poids statiques. Il n'écrit pas. Les poids du modèle ne changent pas pendant l'inférence — ils sont lus et mis en cache en RAM. L'usure du SSD vient principalement de : télécharger les poids (une seule fois à l'installation), les logs système, le swap de l'OS, et la maintenance interne du disque lui-même.
WiCi a publié un modèle d'usure qui suggère que, même en usage intensif (4 heures continues par jour), un SSD de qualité peut durer des années avant d'épuiser son budget d'écriture. Évidemment, ça dépend du disque, de la température et de la charge réelle. Mais l'idée qu'InferSSD « brûle les SSD » est un mythe.
Pourquoi ça change les règles
Si tu peux faire tourner un modèle de 800B sur une RTX 5090, la question « est-ce que j'ai besoin du cloud ? » devient beaucoup plus nuancée.
Tu ne vas pas remplacer GPT-5 chez toi. Mais pour beaucoup d'applications —inférence offline, fine-tuning local, confidentialité des données, expérimentation— avoir accès à des modèles de frontière sur du matériel grand public, c'est un changement de paradigme.
- Pour les chercheurs : tu peux expérimenter avec des modèles state-of-the-art sans payer d'API
- Pour les PME : confidentialité totale, sans envoyer de données à des tiers, avec des modèles qui avant nécessitaient des data centers
- Pour les développeurs : un serveur avec un GPU correct et un SSD rapide peut servir des modèles de 800B à plusieurs utilisateurs en parallèle
Le goulot d'étranglement a toujours été la mémoire. InferSSD le déplace vers le SSD, et les SSD NVMe modernes sont étonnamment rapides. Le « ça ne tient pas sur ma machine » n'est plus une réponse définitive.
Conclusion
InferSSD n'est pas magique. Les gros modèles restent lents sur du matériel modeste. 2.7 tokens/s sur un MacBook ne va pas remplacer une API cloud pour un usage intensif.
Mais ça démontre quelque chose d'important : le monopole du cloud sur les gros modèles s'érode. Avec des SSD NVMe à prix accessible, des GPUs grand public de plus en plus puissants, et de l'ingénierie comme celle d'InferSSD, la barrière pour faire tourner des modèles de frontière localement baisse chaque mois.
Sam Altman dit que ton PC est un gaspillage. InferSSD dit que ton SSD est de la VRAM qui attend d'être utilisée. On garde la deuxième option.
À lire aussi
Prêt pour le saut technologique ?
Ne laissez pas votre PME devenir obsolète. Nous implémentons l'infrastructure IA qui vous donnera l'avantage compétitif.
Réserver Votre Audit Gratuit
