InferSSD: zure SSDa VRAM berria da
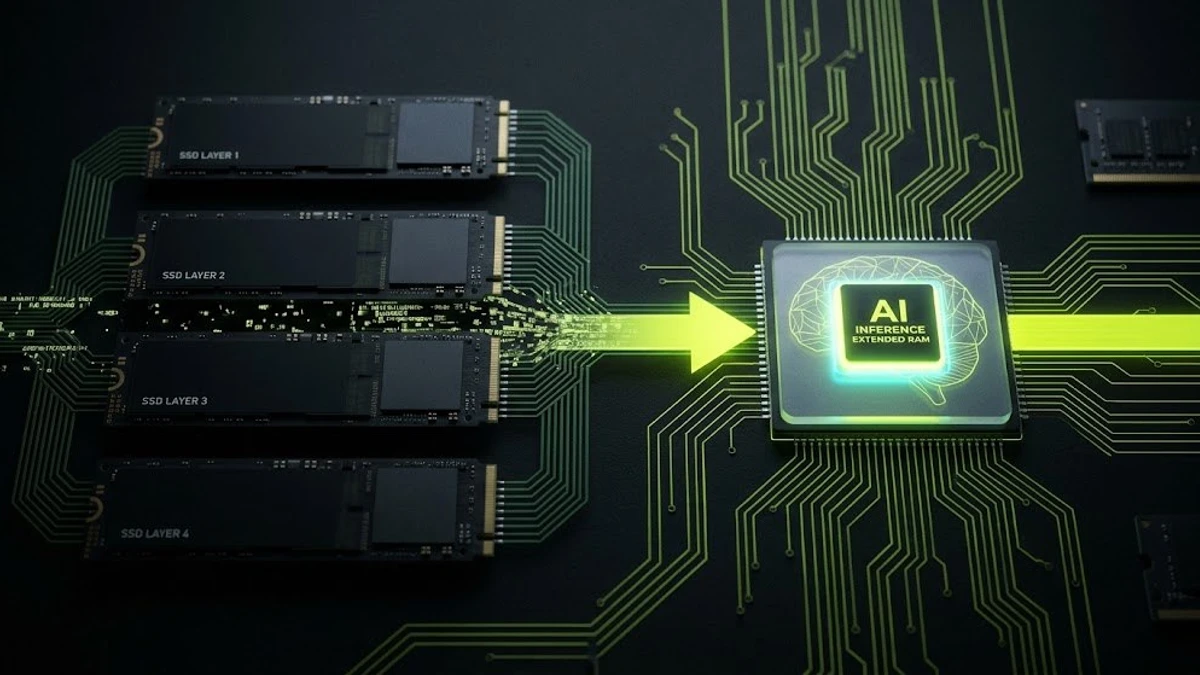
IA lokalean arazo sinple bat dago inork ondo ebatzi ez duena: modelo handiak ez dira zure memorian sartzen. DeepSeek-V4.1 bezalako modelo batek 763 mila milioi parametro ditu. Ehunka gigabyte okupatzen ditu. Zure laptopak 32 ditu. Zure GPUak 16. Kontuak ez du emaitzarik ematen.
Erantzun tradizionala: erosi RAM gehiago. Edo ordaindu cloud harpidetza. Edo konformatu modelo txikiekin.
InferSSDk beste erantzun bat proposatzen du: erabili zure SSDa.
Ideia: SSDa memoria hedatu gisa
InferSSD inferentzia-motor open-source bat da (Apache 2.0 lizentzia), WiCi AIk sortua, llama.cppren gainean eraikia. Bere premisa ulertzeko sinplea da, nahiz eta inplementazioa konplexua izan:
Modelo osoa RAMen edo VRAMen kargatu ordez, pisuak SSDn gordetzen ditu eta behar dena kargatzen du, behar denean.
Baina amankomuren bat dago. Ez edozein modelorekin funtzionatzen — zehazki Mixture-of-Experts (MoE) modelorekin funtzionatzen du. Eta arrazoia eleganteda.
Zergatik MoEk ahalbidetzen duen
MoE eredu batek ez ditu bere parametro guztiak erabiltzen token bakoitzeko. Sortzen duen hitz bakoitzeko, modeloak "espertu" azpimultzo txiki bat aukeratzen du — pentsa ezazu specialisten talde bat bezala, non eginkizun bakoitzeko dagokienak bakarrik kontsultatzen diren.
DeepSeek-V4.1ek 763B parametro total ditu, baina token bakoitzeko frakzio bat bakarrik aktibatzen du. InferSSDk zehazki hau aprobetxatzen du:
- Aldatzen dena (arreta, KV cachea, geruza partekatuak) RAMen/VRAMen geratzen da — azkarra da eta etengabe beharrezkoa da
- Aldatzen ez dena (espertuen pisuak) SSDn geratzen da — ehunka gigabyte dira baina frakzio bat bakarrik behar da uneoro
- Cache adimentsu batek maiz erabilitako espertuak RAMen mantentzen ditu, SSDtik berriro irakurtzea saihestuz
SSDak ez du RAM ordezkatzen. Osatzen du. Sartzen ez diren modeloentzako memoria hedatua da, non parte aktiboa bakarrik kargatu behar den.
Zenbakiak: 800B RTX 5090 batean
Hau ez da teoria. InferSSDk already funtzionatzen du. Benchmarkak harritgarriak dira:
- RTX 5090 (32GB RAM + 32GB VRAM): DeepSeek-V4.1 7.27 tokens/s decodean, 164.5 tokens/s prefillan. Erabilgarria da. 763B-ko modelo bat kontsumitzailearen txartel grafiko batean.
- MacBook Pro M5 Max (48GB bateratua): 2.7 tokens/s decode. Motela baina funtzionala — 763B-ko modelo bat laptop batean.
- RTX 5060 Ti (8GB RAM + 16GB VRAM): 2.55 tokens/s. Bai, 8GB RAM. SSDak lan gogorra egiten du.
Perspektiban jartzeko: llama.cpp InferSSD gabe RTX 5090 berean 0.87 tokens/s egiten du. InferSSD 8.4 aldiz azkarragoa da decodean eta 20 aldiz azkarragoa prefillan.
Ez da bakarra norabide honetan
SSDa IArentzako memoria gisa erabiltzearen ideiak trakzioa irabazten ari da:
- SSD-LLaMA (2026ko irailaren paperak): bilioi bat parametroko MoE modeloentzako SSD-native inferentzia aztertzen du
- llama.cpp Expert-Aware SSD Streaming: komunitatean elkarrizketa aktiboa espertuak SSDtik zuzenean llama.cppra integratzeko
- SGLang SSD Expert Pack: WiCi eta SGLangen arteko lan konjunta biltegiratik espertuetarako sarbidea optimizatzeko
- Gandalf: SSDa KV caching-erako erabiltzearen eta diskoen iraunkortasunaren inguruko ikerketa
Konbergentzia argia da: industriak SSDa ez dela biltegiratze soila deskubritzen ari da — memoria geruza bat gehiago da.
Eta SSDaren iraunkortasuna?
Denek galdetzen duten galdera da. Ez ote du IA eredua SSDtik exekutatzeak diskoa hilko?
Erantzun laburra: ez uste zenukeen bezainbeste.
InferSSDk pisu estatikoak irakurtzen ditu. Ez du idazten. Modeloaren pisuak ez dira aldatzen inferentzian — irakurri eta RAMen cachearatzen dira. SSDaren higadura batez ere hemendik dator: pisuak deskargatzea (behin instalatzean), sistema logak, OSaren swapa, eta diskoaren barne-mantenua.
WiCik higadura-eredu bat argitaratu du iradokitzen duena, erabilera intentsiboan ere (4 ordu jarraian egunean), kalitatezko SSD batek urteak iraun ditzakeela idazketa-budgeta agortu aurretik. Noski, diskoaren, tenperaturaren eta lan-kargaren arabera. Baina InferSSDk "SSDak erretzen dituela" ideia mito bat da.
Zergatik arauak aldatzen dituen
800B-ko modelo bat RTX 5090 batean exekutatu badirezke, "cloud-a behar al dut?" galdera askoz ere matizatuagoa bihurtzen da.
Ez duzu GPT-5 etxean ordeztiko. Baina aplikazio askotarako —offline inferentzia, fine-tuning lokala, datuen pribatutasuna, esperimentazioa— mugako modeloak kontsumitzailearen hardwarean eskuratzeko aukera paradigma-aldaketa da.
- Ikertzaileentzat: state-of-the-art modeloekin esperimentatu dezakezu APIrik ordaindu gabe
- PMEentzat: pribatutasun totala, hirugarrenei datuak bidali gabe, lehen data center-ak behar zituzten modeloekin
- Garatzaileentzat: GPU on bat eta SSD azkarra dituen zerbitzari batek 800B-ko modeloak hainbat erabiltzaileri zerbitzu diezaioke paraleloan
Bottleneck-a beti izan da memoria. InferSSDk SSDra eramaten du, eta NVMe SSD modernoak sorpresan azkarrak dira. "Ez da nire makinan sartzen" ez da erantzun definitibo bat gehiago.
Ondorioa
InferSSD ez da magia. Modelo handiak motelekin jarraitzen dute hardware apalean. 2.7 tokens/s MacBook batean ez du cloud API bat ordezkatuko erabilera intentsiborako.
Baina zerbait garrantzitsua frogatzen du: cloud-aren monopolioa modelo handien gainean higatzen ari da. NVMe SSD merkeekin, kontsumitzailearen GPU gero eta indartsuagoekin, eta InferSSD bezalako ingeniaritzarekin, mugako modeloak lokalki exekutatzeko barriera hilabete bakoitzean jaisten da.
Sam Altmanek zure PCa alferrikako zerbait dela dio. InferSSDk zure SSDa erabili beharrean VRAM dela dio. Gu biggarren aukerarekin geratzen gara.
Interesagarria izan daiteke
Prest salto teknologikorako?
Ez utzi zure ETE zaharkitua geratzen. AA azpiegitura ezartzen dugu lehiakortasun abantaila emango dizuna.
Eskatu Zure Doako Auditoria
