InferSSD: tu SSD es la nueva VRAM
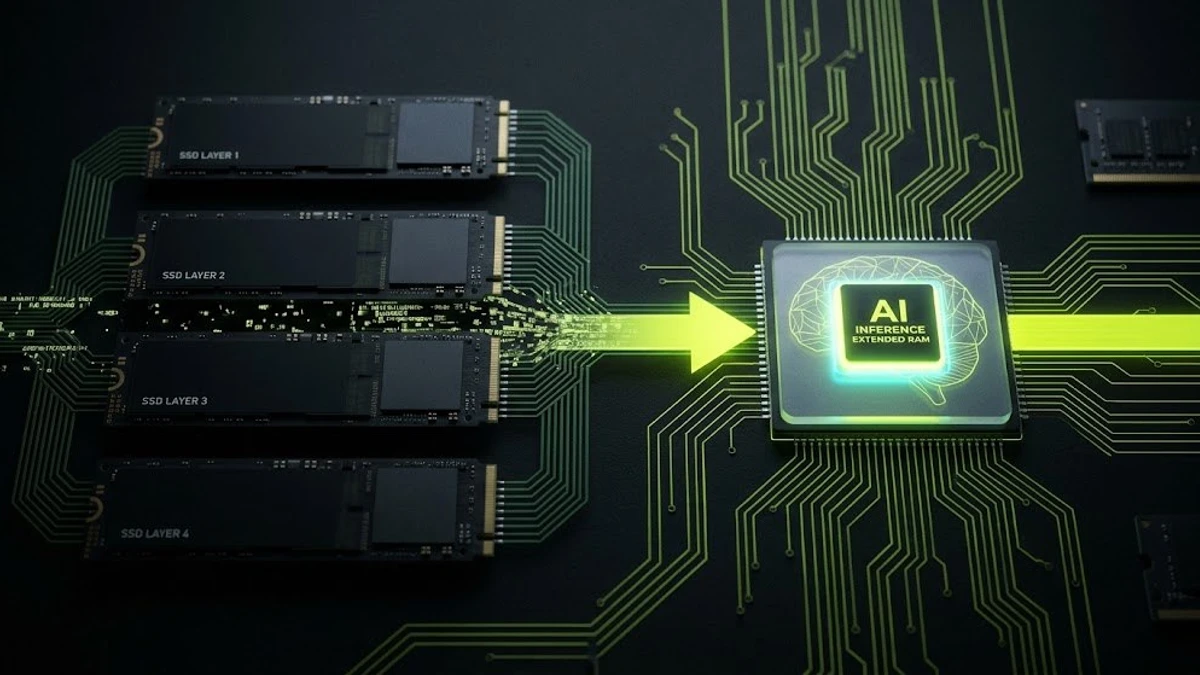
Hay un problema simple en IA local que nadie había resuelto bien: los modelos grandes no caben en tu memoria. Un modelo como DeepSeek-V4.1 tiene 763 mil millones de parámetros. Ocupa cientos de gigabytes. Tu laptop tiene 32. Tu GPU tiene 16. La cuenta no cuadra.
La respuesta tradicional: compra más RAM. O paga una suscripción en la nube. O conformáte con modelos pequeños.
InferSSD propone otra respuesta: usa tu SSD.
La idea: SSD como memoria extendida
InferSSD es un motor de inferencia open-source (licencia Apache 2.0) creado por WiCi AI, construido sobre llama.cpp. Su premisa es simple de entender aunque la implementación sea compleja:
En lugar de cargar todo el modelo en RAM o VRAM, guarda los pesos en el SSD y carga solo lo que se necesita, cuando se necesita.
Pero hay un truco. No funciona con cualquier modelo — funciona específicamente con modelos Mixture-of-Experts (MoE). Y la razón es elegante.
Por qué MoE lo hace posible
Un modelo MoE no usa todos sus parámetros en cada token. Para cada palabra que genera, el modelo selecciona un pequeño subconjunto de "expertos" — piensa en ello como un equipo de especialistas donde solo se consultan los relevantes para cada tarea.
DeepSeek-V4.1 tiene 763B parámetros totales, pero solo activa una fracción para cada token. InferSSD aprovecha exactamente esto:
- Lo que cambia (atención, KV cache, capas compartidas) se queda en RAM/VRAM — es rápido y se necesita constantemente
- Lo que no cambia (los pesos de los expertos) se queda en SSD — son cientos de gigabytes pero solo se necesita una fracción en cada momento
- Un cache inteligente mantiene en RAM los expertos que se usan frecuentemente, evitando releer del SSD
El SSD no reemplaza a la RAM. La complementa. Es memoria extendida para modelos que no caben, con la que solo necesitas cargar la parte activa.
Los números: 800B en una RTX 5090
Esto no es teoría. InferSSD ya funciona. Los benchmarks son sorprendentes:
- RTX 5090 (32GB RAM + 32GB VRAM): DeepSeek-V4.1 a 7.27 tokens/s en decode, 164.5 tokens/s en prefill. Eso es utilizable. Un modelo de 763B, en una tarjeta gráfica de consumo.
- MacBook Pro M5 Max (48GB unificada): 2.7 tokens/s decode. Lento pero funcional — un modelo de 763B en un portátil.
- RTX 5060 Ti (8GB RAM + 16GB VRAM): 2.55 tokens/s. Sí, 8GB de RAM. El SSD hace el trabajo pesado.
Para ponerlo en perspectiva: llama.cpp sin InferSSD en la misma RTX 5090 hace 0.87 tokens/s. InferSSD es 8.4 veces más rápido en decode y 20 veces más rápido en prefill.
No es el único en esta dirección
La idea de usar SSD como memoria para IA está ganando tracción:
- SSD-LLaMA (paper de septiembre 2026): investigación académica sobre inference SSD-native para modelos MoE de un billón de parámetros
- llama.cpp Expert-Aware SSD Streaming: discusión activa en la comunidad para integrar streaming de expertos desde SSD directamente en llama.cpp
- SGLang SSD Expert Pack: trabajo conjunto entre WiCi y SGLang para optimizar el acceso a expertos desde almacenamiento
- Gandalf: estudio sobre el impacto de usar SSD para KV caching y la durabilidad de los discos
La convergencia es clara: la industria está descubriendo que el SSD no es solo almacenamiento — es una capa de memoria más.
¿Y la durabilidad del SSD?
Es la pregunta que todo el mundo hace. ¿Correr un modelo de IA desde SSD no lo va a matar?
La respuesta corta: no como podrías pensar.
InferSSD lee pesos estáticos. No escribe. Los pesos del modelo no cambian durante la inferencia — se leen y se cachean en RAM. El desgaste del SSD viene principalmente de: descargar los pesos (una sola vez al instalar), logs del sistema, swap del OS, y el mantenimiento interno del propio disco.
WiCi publicó un modelo de desgaste que sugiere que, incluso en uso intensivo (4 horas continuas al día), un SSD de calidad puede durar años antes de agotar su budget de escritura. Obviamente, esto depende del disco, la temperatura y el workload real. Pero la idea de que InferSSD "quema SSD" es un mito.
Por qué esto cambia las reglas
Si puedes correr un modelo de 800B en una RTX 5090, la pregunta "¿necesito la nube?" se vuelve mucho más matizada.
No vas a reemplazar GPT-5 en tu casa. Pero para muchas aplicaciones —inferencia offline, fine-tuning local, privacidad de datos, experimentación— tener acceso a modelos de frontera en hardware de consumo es un cambio de paradigma.
- Para investigadores: puedes experimentar con modelos state-of-the-art sin pagar API
- Para pymes: privacidad total, sin enviar datos a terceros, con modelos que antes requerían data centers
- Para desarrolladores: un servidor con una GPU decente y un SSD rápido puede servir modelos de 800B a varios usuarios en paralelo
El cuello de botella siempre fue la memoria. InferSSD lo mueve al SSD, y los SSD NVMe modernos son sorprendentemente rápidos. El "no cabe en mi máquina" ya no es una respuesta definitiva.
Conclusión
InferSSD no es magia. Los modelos grandes siguen siendo lentos en hardware modesto. 2.7 tokens/s en un MacBook no va a reemplazar una API cloud para uso intensivo.
Pero demuestra algo importante: el monopolio de la nube sobre los modelos grandes se está erosionando. Con SSDs NVMe a precios accesibles, GPUs de consumo cada vez más potentes, e ingeniería como la de InferSSD, la barrera para correr modelos de frontera localmente baja cada mes.
Sam Altman dice que tu PC es un desperdicio. InferSSD dice que tu SSD es una VRAM esperando ser usada. Nosotros nos quedamos con la segunda opción.
También te puede interesar
¿Listo para el salto tecnológico?
No dejes que tu pyme quede obsoleta. Implementamos la infraestructura de IA que te dará la ventaja competitiva.
Reserva tu Auditoría Gratuita
